LFUキャッシュアルゴリズムとは?
LFUとは?
LFUは「Least Frequently Used」の略です。
LFU Cacheは一般的なキャッシュ管理アルゴリズムで、その設計思想はキャッシュがいっぱいになったときに、キャッシュ内で最も使用頻度の低いデータを追い出すことです。このシンプルな仕組みにより、キャッシュに格納されるデータが可能な限り有用であることを保証し、キャッシュのヒット率を向上させます。
LFUの適用シナリオ
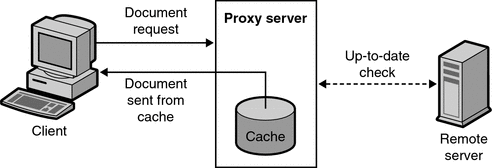
LFUの代表的な適用シナリオはHTTPキャッシュプロキシ(proxy)アプリケーションで、ネットワークサービスとユーザーの間に位置します。以下の図の通りです。
image
(画像出典 Oracle)
キャッシュプロキシの役割は、キャッシュサーバー上の限られたストレージスペースに、可能な限り人気のある静的ファイルをキャッシュし、ネットワークサービスの応答速度を向上させ、ネットワーク利用率を最適化することです。その実装コストは可能な限り小さくし、高負荷下でもプロキシが正常に動作できるようにする必要があります。
LRUも良い選択肢ですが、特定のシナリオ、例えば一連の異なるデータにアクセスし、そのアクセス順序がラウンドロビンである場合、キャッシュが絶えず置き換えられ、LFUが機能しなくなる可能性があります。
インターフェース設計
class LFUCache {
Public:
    // 1. 容量サイズのキャッシュを構築する
    LFUCache(int capacity) {}
    // 1. キーに対応する値を取得する
    // 2. 見つからない場合は-1を返す
    int get(int key) {}
    // 1. キーと値のペアをキャッシュに格納する
    // 2. キャッシュがいっぱいの場合は、最も使用頻度の低いデータを削除する
    // 3. 同じ頻度のデータが複数ある場合は、最も最近使用されていないものを削除する
    void put(int key, int val) {}
}
データ構造設計
LFUキャッシュの実装は、getおよびput操作の時間計算量をO(1)にするために、2つのハッシュテーブルに依存しています。
1つ目のハッシュテーブルはキーと値のペアを格納するために使用されます。
2つ目のハッシュテーブルは各キーのアクセス頻度を格納するために使用されます。
各キーのアクセス頻度は、最も使用頻度の低いデータの順序を決定するために使用されます。
最も使用頻度の低いデータとは、アクセス頻度が最小のデータを指します。複数のデータのアクセス頻度が同じ場合、最も使用頻度の低いデータは、最も長い間アクセスされていないデータです。
C++ サンプルコード
#include <list>
#include <random>
#include <iostream>
#include <unordered_map>

using namespace std;

struct Node
{
    int key;
    int value;
    int freqeuncy;
    Node(int k, int v, int f) : key(k), value(v), freqeuncy(f) {}
};

class LFUCache
{
private:
    int minFreq;                                        // キャッシュの最小頻度
    int capacity;                                       // キャッシュの最大容量
    unordered_map<int, list<Node>::iterator> key_table; // キーとイテレータのマッピングテーブル
    unordered_map<int, list<Node>> freq_table;          // 頻度とリストのマッピングテーブル

public:
    int HIT = 0;
    int MISS = 0;

    LFUCache(int capacity){
        this->capacity = capacity;
        minFreq = 0;
        key_table.clear();
        freq_table.clear();
    }

    int get(const int &key)
    {
        // 容量が0の場合は-1を返す
        if (capacity == 0)
        {
            return -1;
        }
        // ノードのイテレータを探す
        auto it = key_table.find(key);
        // ノードが見つからない場合は-1を返す
        if (it == key_table.end())
        {
            MISS++;
            return -1;
        }
        list<Node>::iterator node = it->second;
        int value = node->value;
        int freq = node->freqeuncy;
        freq_table[freq].erase(node);
        // リストが空の場合、マップから削除し、最小頻度を更新する
        if (freq_table[minFreq].size() == 0)
        {
            freq_table.erase(freq);
            // 最小頻度が現在の頻度と等しい場合、min_freqを増やす
            if (minFreq == freq)
                minFreq++;
        }
        // ノードをfreq + 1の位置に挿入する
        freq_table[freq + 1].push_front(Node(key, value, freq + 1));
        // マップ内のイテレータを更新する
        key_table[key] = freq_table[freq + 1].begin();
        HIT++;
        return value;
    }

    void put(int key, int value)
    {
        // 容量が0の場合は戻る
        if (capacity == 0)
            return;
        // ノードのイテレータを探す
        auto it = key_table.find(key);
        if (it == key_table.end())
        {
            // キーがキャッシュにない場合、挿入する
            // 最初に容量を確認する
            if (key_table.size() == capacity)
            {
                // キャッシュがいっぱいの場合、最も使用頻度の低いノードを削除する
                // 最小頻度で最後のノードを取得する
                auto minNode = freq_table[minFreq].back();
                key_table.erase(minNode.key);
                // 新しいノードを挿入する
                freq_table[minFreq].pop_back();
                if (freq_table[minFreq].size() == 0)
                {
                    // リストが空の場合、マップから削除する
                    freq_table.erase(minFreq);
                }
            }
            // マップ内のイテレータを更新する
            minFreq = 1;
            freq_table[minFreq].push_front(Node(key, value, minFreq));
            key_table[key] = freq_table[minFreq].begin();
        }
        else
        {
            // キーがキャッシュにある場合、頻度を更新する
            list<Node>::iterator node = it->second;
            int freq = node->freqeuncy;
            freq_table[freq].erase(node);
            if (freq_table[freq].size() == 0)
            {
                // 古い頻度を削除する
                freq_table.erase(freq);
                // min_freq == cur_freqの場合、min_freqを更新する
                if (minFreq == freq)
                    minFreq++;
            }
            // ノードをfreq + 1の位置に挿入する
            freq_table[freq + 1].push_front(Node(key, value, freq + 1));
            // マップ内のイテレータを更新する
            key_table[key] = freq_table[freq + 1].begin();
        }
    }

    void clear()
    {
        key_table.clear();
        freq_table.clear();
        minFreq = 0;
        HIT = 0;
        MISS = 0;
    }
};

void testCase(){
    // leetcodeの例から
    LFUCache cache(2);
    cache.put(1, 1);
    cache.put(2, 2);
    cout << cache.get(1) << endl; // 1を返す
    cache.put(3, 3);              // キー2を追い出す
    cout << cache.get(2) << endl; // -1を返す (見つからない)
    cout << cache.get(3) << endl; // 3を返す
    cache.put(4, 4);              // キー1を追い出す
    cout << cache.get(1) << endl; // -1を返す (見つからない)
    cout << cache.get(3) << endl; // 3を返す
    cout << cache.get(4) << endl; // 4を返す
}

int main()
{
    // testCase();

    const int CAPACITY = 200;
    const int NUM = 1000;

    LFUCache cache(CAPACITY);

    // シーケンシャルアクセス
    cout << "Sequential Access" << endl;
    cache.clear();
    for (int i = 0; i < NUM; ++i)
    {
        if (cache.get(i) == -1)
        {
            cache.put(i, i);
        }
    }
    cout << "HIT: " << cache.HIT << "\t\tMISS: " << cache.MISS
         << "\t\tHit Rate: " << (double)cache.HIT / (cache.HIT + cache.MISS) << endl;

    // 一様分布によるランダムアクセス
    cout << "Random Access with Uniform Distribution" << endl;
    cache.clear();
    random_device rd;
    mt19937 gen(rd());
    uniform_int_distribution<> dis(0, NUM);
    for (int i = 0; i < NUM; ++i)
    {
        int key = dis(gen);
        if (cache.get(key) == -1)
        {
            cache.put(key, key);
        }
    }

    cout << "HIT: " << cache.HIT << "\t\tMISS: " << cache.MISS
         << "\t\tHit Rate: " << (double)cache.HIT / (cache.HIT + cache.MISS) << endl;


    // 正規分布によるランダムアクセス
    cout << "Random Access with Normal Distribution" << endl;
    cache.clear();
    int mu = NUM / 2;
    int sigma = NUM / 6;
    normal_distribution<> ndis(mu, sigma);
    for (int i = 0; i < NUM*10; ++i)
    {
        int key = ndis(gen);
        if (cache.get(key) == -1)
        {
            cache.put(key, key);
        }
    }

    cout << "HIT: " << cache.HIT << "\t\tMISS: " << cache.MISS
         << "\t\tHit Rate: " << (double)cache.HIT / (cache.HIT + cache.MISS) << endl;

    return 0;
}
LFUの潜在的な問題
ホットデータがキャッシュから追い出されにくい:一部のデータは短時間に高頻度でアクセスされるだけかもしれません。しかし、その間に高い頻度を蓄積するため、ホット期間が過ぎた後も長時間キャッシュに残り、追い出されにくくなります。
新しく追加されたデータがキャッシュから追い出されやすい:頻度が最小のデータのみを追い出す場合、新しく追加されたデータはより追い出されやすくなります。これは、新しいデータの頻度がデフォルトで1であるのに対し、古いデータは長期間蓄積されているため、頻度が新しいデータよりもはるかに高いためです。
スペースの問題:すべてのデータのアクセス情報を記録すると、より多くのメモリスペースを占有します。
LFUの改良版
LFU-Aging
LFU-Agingは、LFUとLRUの両方の特性を組み合わせたハイブリッドな追い出し戦略です。LFUと同様に各キーのアクセス頻度を記録しますが、キーの経過時間も考慮し、減衰係数を使用して最近アクセスされたキーにより高い優先度を与えます。
LFU-Agingの追い出し戦略は、カウンターによって実装されます。キーにアクセスするたびに、カウンターが増加します。時間の経過とともに、カウンターは減衰係数を使用して減衰します。ユーザーは設定により減衰係数を調整できます。キーがキャッシュから追い出されるとき、カウンターの値が最も小さいキーが追い出されます。
LFUとLRUの特性を組み合わせることで、LFU-Agingはキーのアクセス頻度とアクセスの新しさの両方を考慮し、2つの方法のバランスを取ることを目的としています。これにより、キャッシュの追い出しと補充の問題を防ぎ、キャッシュ全体のパフォーマンスを向上させることができます。
Redisでは、上記の3つの問題を解決するために、LFU-Agingは以下の3つの戦略を導入しています。
server.lfulogfactorパラメータを設定することで、カウンターの増加率を調整します。
- このパラメータが大きいほど、カウンターの増加率は遅くなります。
server.lfudecaytimeパラメータを設定することで、カウンターの減衰率を調整します。
- このパラメータは、カウンターが最小頻度に減衰するまでの時間を決定します。
LFUINITVAL変数の値を設定することで、カウンターの初期値を調整します。
- デフォルト値は5です。
Window-LFU
Window-LFUは、LFU追い出し戦略の一種の変種です。
従来のLFUと同様に、Window-LFUもキャッシュ内のキーのアクセス頻度を追跡し、アクセス頻度が最も低いキーを特定して追い出すことを目的としています。
しかし、従来のLFUとは異なり、キーにアクセスするたびに、スライディングウィンドウ方式を使用してキーのアクセス頻度の追跡を更新します。
Window-LFUでは、キャッシュは一連の固定サイズのウィンドウに分割され、各ウィンドウがキーのアクセス頻度を追跡します。キーにアクセスされると、そのカウンターは現在のウィンドウ内で増加します。時間の経過とともにウィンドウは前方にスライドし、各キーのカウンターは減少するため、カウンターは現在のウィンドウにおけるキーのアクセス頻度を反映するようになります。キャッシュが容量に達すると、カウンターの低いキーが追い出しの候補としてマークされます。
Window-LFUは、時間の経過とともに変化するアクセスパターンに適応できるため、非常に魅力的であり、さまざまな設定で良好に機能することが実証されています。ただし、実際には広く使用されておらず、Redisなどの一般的なキャッシュアプリケーションにも実装されていません。
まとめ
この記事では、LFU(Least Frequently Used)追い出し戦略について紹介しました。これは、キャッシュ内のキーのアクセス頻度を追跡し、最もアクセス頻度の低いキーを追い出すキャッシュ追い出し戦略です。また、LFUの2つの変種、LFU-AgingとWindow-LFUについても紹介しました。これらは、キーの経過時間を考慮したり、スライディングウィンドウ方式を使用してキーのアクセス頻度を追跡したりすることで、LFUの潜在的なパフォーマンス問題を解決することを目的としています。
参考資料
An O(1) algorithm for implementing the LFU cache eviction scheme