LFU 캐시 알고리즘이란?
LFU란?
LFU는 "Least Frequently Used"의 약자입니다.
LFU Cache는 일반적인 캐시 관리 알고리즘으로, 캐시가 가득 찼을 때 가장 자주 사용되지 않는 데이터를 제거하는 설계 사상을 가지고 있습니다. 이 간단한 메커니즘을 통해 캐시에 저장된 데이터가 최대한 유용하도록 보장하여 캐시 적중률을 높입니다.
LFU의 적용 시나리오
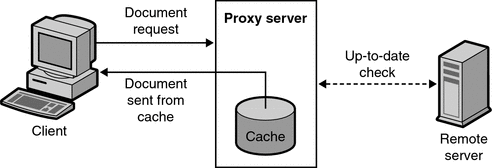
LFU의 대표적인 적용 시나리오는 HTTP 캐시 프록시(proxy) 애플리케이션으로, 네트워크 서비스와 사용자 사이에 위치합니다. 아래 그림과 같습니다.
image
(이미지 출처 Oracle)
캐시 프록시의 역할은 캐시 서버의 제한된 저장 공간에 인기 있는 정적 파일을 최대한 캐싱하여 네트워크 서비스의 응답 속도를 높이고 네트워크 사용률을 최적화하는 것입니다. 구현 비용은 가능한 한 작아야 높은 부하에서도 프록시가 정상적으로 작동할 수 있습니다.
LRU도 좋은 선택이지만, 특정 시나리오(예: 일련의 서로 다른 데이터에 폴링 방식으로 접근하는 경우)에서는 캐시가 계속 교체되어 LFU가 제대로 작동하지 않을 수 있습니다.
인터페이스 설계
class LFUCache {
Public:
    // 1. capacity 크기의 캐시를 생성합니다.
    LFUCache(int capacity) {}
    // 1. 키로 값을 검색합니다.
    // 2. 찾지 못하면 -1을 반환합니다.
    int get(int key) {}
    // 1. 키-값 쌍을 캐시에 저장합니다.
    // 2. 캐시가 가득 차면 가장 자주 사용되지 않는 데이터를 삭제합니다.
    // 3. 여러 데이터의 빈도가 같다면 가장 오랫동안 사용되지 않은 데이터를 삭제합니다.
    void put(int key, int val) {}
}
자료구조 설계
LFU 캐시의 구현은 두 개의 해시 테이블에 의존하여 get 및 put 연산의 시간 복잡도를 O(1)로 만듭니다.
첫 번째 해시 테이블은 키-값 쌍을 저장합니다.
두 번째 해시 테이블은 각 키의 접근 빈도를 저장합니다.
각 키의 접근 빈도는 가장 자주 사용되지 않는 데이터의 순서를 결정하는 데 사용됩니다.
가장 자주 사용되지 않는 데이터는 접근 빈도가 가장 작은 데이터를 의미하며, 여러 데이터의 접근 빈도가 같다면 가장 오랫동안 접근되지 않은 데이터가 가장 자주 사용되지 않는 데이터입니다.
C++ 예제 코드
#include <list>
#include <random>
#include <iostream>
#include <unordered_map>

using namespace std;

struct Node
{
    int key;
    int value;
    int freqeuncy;
    Node(int k, int v, int f) : key(k), value(v), freqeuncy(f) {}
};

class LFUCache
{
private:
    int minFreq;                                        // 캐시의 최소 빈도
    int capacity;                                       // 캐시의 최대 용량
    unordered_map<int, list<Node>::iterator> key_table; // 키를 반복자에 매핑하는 테이블
    unordered_map<int, list<Node>> freq_table;          // 빈도를 리스트에 매핑하는 테이블

public:
    int HIT = 0;
    int MISS = 0;

    LFUCache(int capacity){
        this->capacity = capacity;
        minFreq = 0;
        key_table.clear();
        freq_table.clear();
    }

    int get(const int &key)
    {
        // 용량이 0이면 -1 반환
        if (capacity == 0)
        {
            return -1;
        }
        // 노드의 반복자 찾기
        auto it = key_table.find(key);
        // 노드를 찾지 못하면 -1 반환
        if (it == key_table.end())
        {
            MISS++;
            return -1;
        }
        list<Node>::iterator node = it->second;
        int value = node->value;
        int freq = node->freqeuncy;
        freq_table[freq].erase(node);
        // 리스트가 비어 있으면 맵에서 제거하고 최소 빈도 업데이트
        if (freq_table[minFreq].size() == 0)
        {
            freq_table.erase(freq);
            // 최소 빈도가 현재 빈도와 같으면 min_freq 증가
            if (minFreq == freq)
                minFreq++;
        }
        // 노드를 freq + 1 위치에 삽입
        freq_table[freq + 1].push_front(Node(key, value, freq + 1));
        // 맵의 반복자 업데이트
        key_table[key] = freq_table[freq + 1].begin();
        HIT++;
        return value;
    }

    void put(int key, int value)
    {
        // 용량이 0이면 반환
        if (capacity == 0)
            return;
        // 노드의 반복자 찾기
        auto it = key_table.find(key);
        if (it == key_table.end())
        {
            // 키가 캐시에 없으면 삽입
            // 먼저 용량 확인
            if (key_table.size() == capacity)
            {
                // 캐시가 가득 찼으면 가장 자주 사용되지 않는 노드 제거
                // 최소 빈도로 마지막 노드 가져오기
                auto minNode = freq_table[minFreq].back();
                key_table.erase(minNode.key);
                // 이제 새 노드 삽입
                freq_table[minFreq].pop_back();
                if (freq_table[minFreq].size() == 0)
                {
                    // 리스트가 비어 있으면 맵에서 제거
                    freq_table.erase(minFreq);
                }
            }
            // 맵의 반복자 업데이트
            minFreq = 1;
            freq_table[minFreq].push_front(Node(key, value, minFreq));
            key_table[key] = freq_table[minFreq].begin();
        }
        else
        {
            // 키가 캐시에 있으면 빈도 업데이트
            list<Node>::iterator node = it->second;
            int freq = node->freqeuncy;
            freq_table[freq].erase(node);
            if (freq_table[freq].size() == 0)
            {
                // 이전 빈도 제거
                freq_table.erase(freq);
                // min_freq == cur_freq이면 min_freq 업데이트
                if (minFreq == freq)
                    minFreq++;
            }
            // 노드를 freq + 1 위치에 삽입
            freq_table[freq + 1].push_front(Node(key, value, freq + 1));
            // 맵의 반복자 업데이트
            key_table[key] = freq_table[freq + 1].begin();
        }
    }

    void clear()
    {
        key_table.clear();
        freq_table.clear();
        minFreq = 0;
        HIT = 0;
        MISS = 0;
    }
};

void testCase(){
    // leetcode 예제에서 가져옴
    LFUCache cache(2);
    cache.put(1, 1);
    cache.put(2, 2);
    cout << cache.get(1) << endl; // 1 반환
    cache.put(3, 3);              // 키 2 제거
    cout << cache.get(2) << endl; // -1 반환 (찾을 수 없음)
    cout << cache.get(3) << endl; // 3 반환
    cache.put(4, 4);              // 키 1 제거
    cout << cache.get(1) << endl; // -1 반환 (찾을 수 없음)
    cout << cache.get(3) << endl; // 3 반환
    cout << cache.get(4) << endl; // 4 반환
}

int main()
{
    // testCase();

    const int CAPACITY = 200;
    const int NUM = 1000;

    LFUCache cache(CAPACITY);

    // 순차 접근
    cout << "Sequential Access" << endl;
    cache.clear();
    for (int i = 0; i < NUM; ++i)
    {
        if (cache.get(i) == -1)
        {
            cache.put(i, i);
        }
    }
    cout << "HIT: " << cache.HIT << "\t\tMISS: " << cache.MISS
         << "\t\tHit Rate: " << (double)cache.HIT / (cache.HIT + cache.MISS) << endl;

    // 균등 분포를 사용한 랜덤 접근
    cout << "Random Access with Uniform Distribution" << endl;
    cache.clear();
    random_device rd;
    mt19937 gen(rd());
    uniform_int_distribution<> dis(0, NUM);
    for (int i = 0; i < NUM; ++i)
    {
        int key = dis(gen);
        if (cache.get(key) == -1)
        {
            cache.put(key, key);
        }
    }

    cout << "HIT: " << cache.HIT << "\t\tMISS: " << cache.MISS
         << "\t\tHit Rate: " << (double)cache.HIT / (cache.HIT + cache.MISS) << endl;


    // 정규 분포를 사용한 랜덤 접근
    cout << "Random Access with Normal Distribution" << endl;
    cache.clear();
    int mu = NUM / 2;
    int sigma = NUM / 6;
    normal_distribution<> ndis(mu, sigma);
    for (int i = 0; i < NUM*10; ++i)
    {
        int key = ndis(gen);
        if (cache.get(key) == -1)
        {
            cache.put(key, key);
        }
    }

    cout << "HIT: " << cache.HIT << "\t\tMISS: " << cache.MISS
         << "\t\tHit Rate: " << (double)cache.HIT / (cache.HIT + cache.MISS) << endl;

    return 0;
}
LFU의 잠재적 문제점
핫 데이터가 캐시에서 쉽게 제거되지 않음: 일부 데이터는 단기간에 높은 빈도로 접근될 수 있습니다. 하지만 이 기간 동안 높은 빈도를 축적했기 때문에 핫 기간이 지난 후에도 오랫동안 캐시에 남아 쉽게 제거되지 않습니다.
새로 추가된 데이터가 캐시에서 더 쉽게 제거됨: 빈도가 가장 낮은 데이터만 제거한다면 새로 추가된 데이터가 더 쉽게 제거됩니다. 새로 추가된 데이터의 기본 빈도는 1인 반면, 오래된 데이터는 오랜 시간 축적되어 빈도가 훨씬 높기 때문입니다.
공간 문제: 모든 데이터의 접근 정보를 기록하면 더 많은 메모리 공간을 차지합니다.
LFU의 몇 가지 개선 사항
LFU-Aging
LFU-Aging은 LFU와 LRU의 일부 특징을 결합한 혼합 제거 전략입니다. LFU와 마찬가지로 각 key의 접근 빈도를 기록하지만, key의 수명(age)도 고려하여 감쇠 인자(decay factor)를 사용해 최근에 접근된 key에 더 높은 우선순위를 부여합니다.
LFU-Aging 제거 전략은 카운터를 통해 구현됩니다. key에 접근할 때마다 카운터가 증가합니다. 시간이 지남에 따라 카운터는 감쇠 인자를 사용하여 감소합니다. 사용자는 설정을 통해 감쇠 인자를 구성할 수 있습니다. key가 캐시에서 제거될 때 카운터 값이 가장 작은 key가 제거됩니다.
LFU와 LRU의 일부 특징을 결합함으로써 LFU-Aging은 key의 접근 빈도와 접근의 최근성을 모두 고려하여 두 방법 간의 균형을 맞추는 것을 목표로 합니다. 이는 캐시 제거 및 채우기 문제를 방지하고 캐시의 전반적인 성능을 향상시킬 수 있습니다.
Redis에서는 위의 세 가지 문제를 해결하기 위해 LFU-Aging이 다음과 같은 세 가지 전략을 도입했습니다.
server.lfulogfactor 매개변수를 구성하여 카운터의 증가 속도를 조정합니다.
- 이 매개변수가 클수록 카운터 증가 속도가 느려집니다.
server.lfudecaytime 매개변수를 구성하여 카운터의 감소 속도를 조정합니다.
- 이 매개변수는 카운터가 최소 빈도로 감소하는 데 걸리는 시간을 결정합니다.
LFUINITVAL 변수 값을 설정하여 카운터의 초기 값을 조정합니다.
- 기본값은 5입니다.
Window-LFU
Window-LFU는 LFU 제거 전략의 변형입니다.
기존 LFU와 마찬가지로 Window-LFU도 캐시 내 key의 접근 빈도를 추적하여 접근 빈도가 가장 낮은 key를 식별하고 제거하는 것을 목표로 합니다.
그러나 기존 LFU와 달리 key에 접근할 때마다 슬라이딩 윈도우(sliding window) 방법을 사용하여 key의 접근 빈도 추적을 업데이트합니다.
Window-LFU에서 캐시는 일련의 고정된 크기의 윈도우로 나뉘며, 각 윈도우는 key의 접근 빈도를 추적합니다. key에 접근하면 현재 윈도우에서 해당 카운터가 증가합니다. 시간이 지남에 따라 윈도우가 앞으로 이동(slide)하고 각 key의 카운터는 감소하여 카운터가 현재 윈도우에서의 key 접근 빈도를 반영하게 됩니다. 캐시가 용량에 도달하면 카운터가 낮은 key가 제거 후보로 표시됩니다.
Window-LFU는 시간이 지남에 따라 변하는 접근 패턴에 적응할 수 있고 다양한 설정에서 좋은 성능을 보이는 것으로 입증되었기 때문에 매우 매력적입니다. 그러나 실제로 널리 사용되지는 않으며 Redis와 같은 인기 있는 캐시 애플리케이션에서 구현되지 않았습니다.
요약
이 글에서는 LFU(Least Frequently Used) 제거 전략에 대해 소개했습니다. 이는 캐시 내 key의 접근 빈도를 추적하고 접근 빈도가 가장 낮은 key를 제거하는 캐시 제거 전략입니다. 또한 LFU의 두 가지 변형인 LFU-Aging과 Window-LFU를 소개했습니다. 이들은 key의 수명을 고려하고 슬라이딩 윈도우 방법을 사용하여 key의 접근 빈도를 추적함으로써 LFU의 잠재적인 성능 문제를 해결하는 것을 목표로 합니다.
참고 자료
An O(1) algorithm for implementing the LFU cache eviction scheme